La cause technique
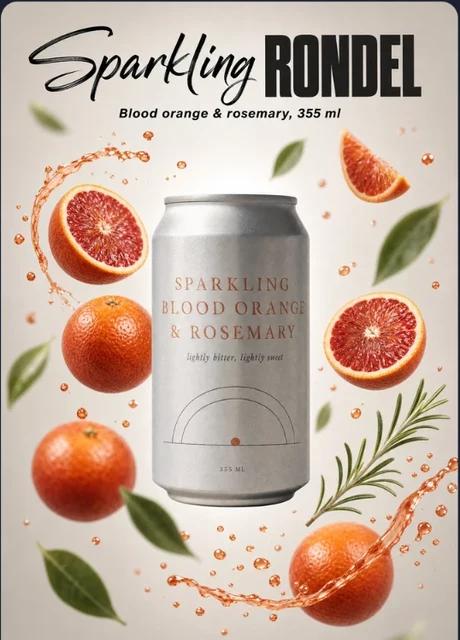
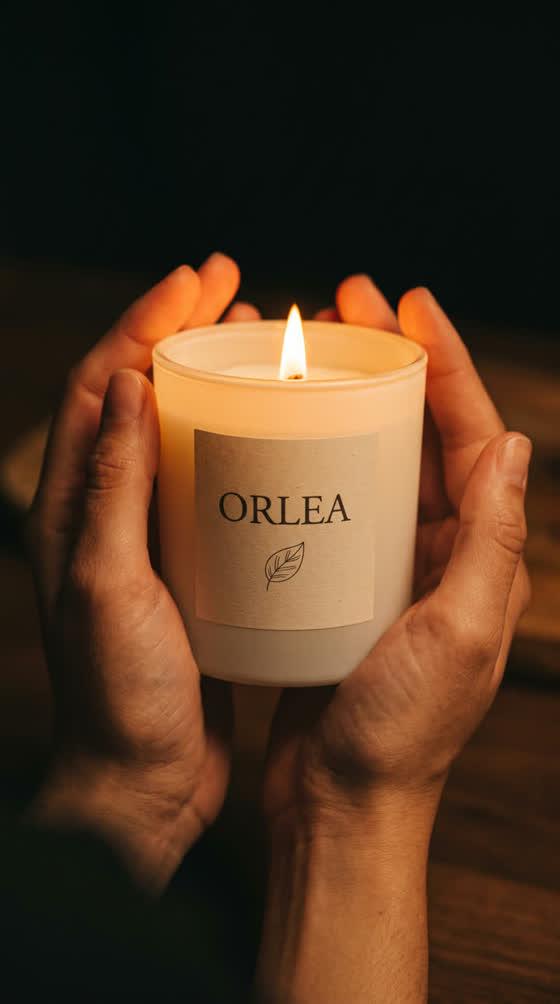
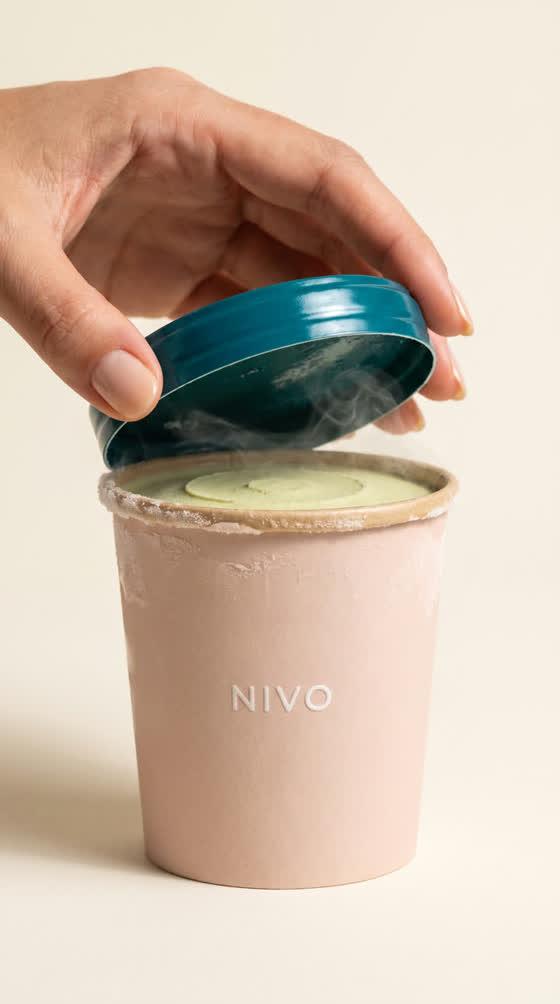
Un modèle de génération d'image apprend à partir de motifs statistiques, pas d'une compréhension anatomique ou linguistique. Une main a une structure très variable selon l'angle et la pose, avec peu de marge d'erreur avant que le résultat paraisse faux à l'œil humain, un doigt en trop ou une articulation mal placée se remarque immédiatement. Le texte intégré à une image pose un problème différent : le modèle génère des formes qui ressemblent à des lettres sans nécessairement « écrire » au sens strict, d'où des caractères déformés ou incohérents.
Les correctifs qui fonctionnent
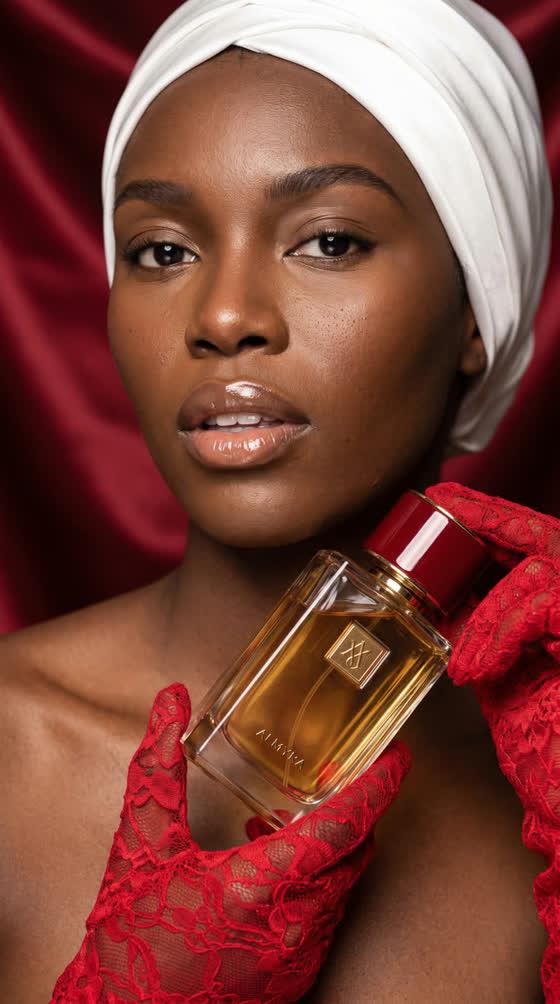
- Cadrer pour limiter la visibilité : un plan plus serré ou des mains partiellement hors champ réduisent le risque sans rien changer au moteur.
- Préciser la pose dans le prompt: décrire une position simple (« mains croisées », « une main tenant une tasse ») plutôt que de laisser le modèle improviser une pose complexe.
- Ne pas compter sur le texte généré : pour un logo, un packaging ou tout texte qui doit rester lisible, ajoutez-le en retouche après génération plutôt que de le confier au prompt.
- Générer plusieurs variantes, plutôt qu'une seule génération, en produire trois ou quatre et garder la meilleure reste souvent plus rapide que d'essayer de corriger un rendu raté.
Pour la méthode complète de structuration d'un prompt, voir notre guide comment écrire un bon prompt pour générer une image IA.
Questions fréquentes
À des degrés divers, oui, c'est une limite structurelle de la génération d'image actuelle, pas un défaut propre à un seul outil. Les modèles les plus récents progressent sur ce point, sans l'avoir totalement résolu.
Parfois, mais ce n'est pas fiable en soi. Ajuster le cadrage pour limiter la visibilité des mains, ou passer par une retouche manuelle ciblée, donne un résultat plus prévisible que de multiplier les générations au hasard.
Pour aller plus loin